-
토큰은 돈이다 시즌2 2편 - 압축 레이어를 가르고, 기본 OFF를 같은 날 오후에 뒤집었다AI 엔지니어링 2026. 10. 27. 07:29728x90반응형
비슷한 도구가 나왔을 때 기능 목록을 대조하는 대신 압축을 세 레이어로 갈랐고, 그 결과 한 레이어는 포기하고 한 레이어의 기본값은 뒤집었다.
6월 중순, 출력 압축 도구 scrooge를 막 출시하고 발표 수치를 정직하게 고치는 작업에 파묻혀 있을 때 비슷한 결의 도구를 봤다. ponytail — 에이전트가 코드를 덜 쓰게 만드는 Claude Code skill이다. "이게 정말 필요한가"부터 시작하는 사다리를 태워, 이미 있는 것·표준 라이브러리·한 줄로 되는 것을 훑고 나서야 새 코드를 쓰게 한다. 절약이라는 단어를 쓰고, 토큰 절감 수치를 내걸고, 대상 호스트도 같다.
첫 반응은 기능 목록을 여는 것이었다. 저쪽에 있고 우리에게 없는 게 뭔가. 두 줄 때쯤 적다가 손을 멈췄다. 그 표를 끝까지 채우면 결론은 정해져 있다 — 없는 걸 채운다. 그건 로드맵이 아니라 남의 로드맵이다. 질문을 바꿨다. 토큰은 대체 어디서 청구되는가.
청구되는 자리는 세 곳뿐이다
한 턴을 놓고 보면 토큰이 도는 자리는 셋이다. 컨텍스트로 들어가는 input, 모델이 뱉는 산문, 모델이 뱉는 코드. 압축 도구는 반드시 이 셋 중 하나 이상을 친다. 그렇게 갈라놓으니 표가 아니라 지도가 나왔다.
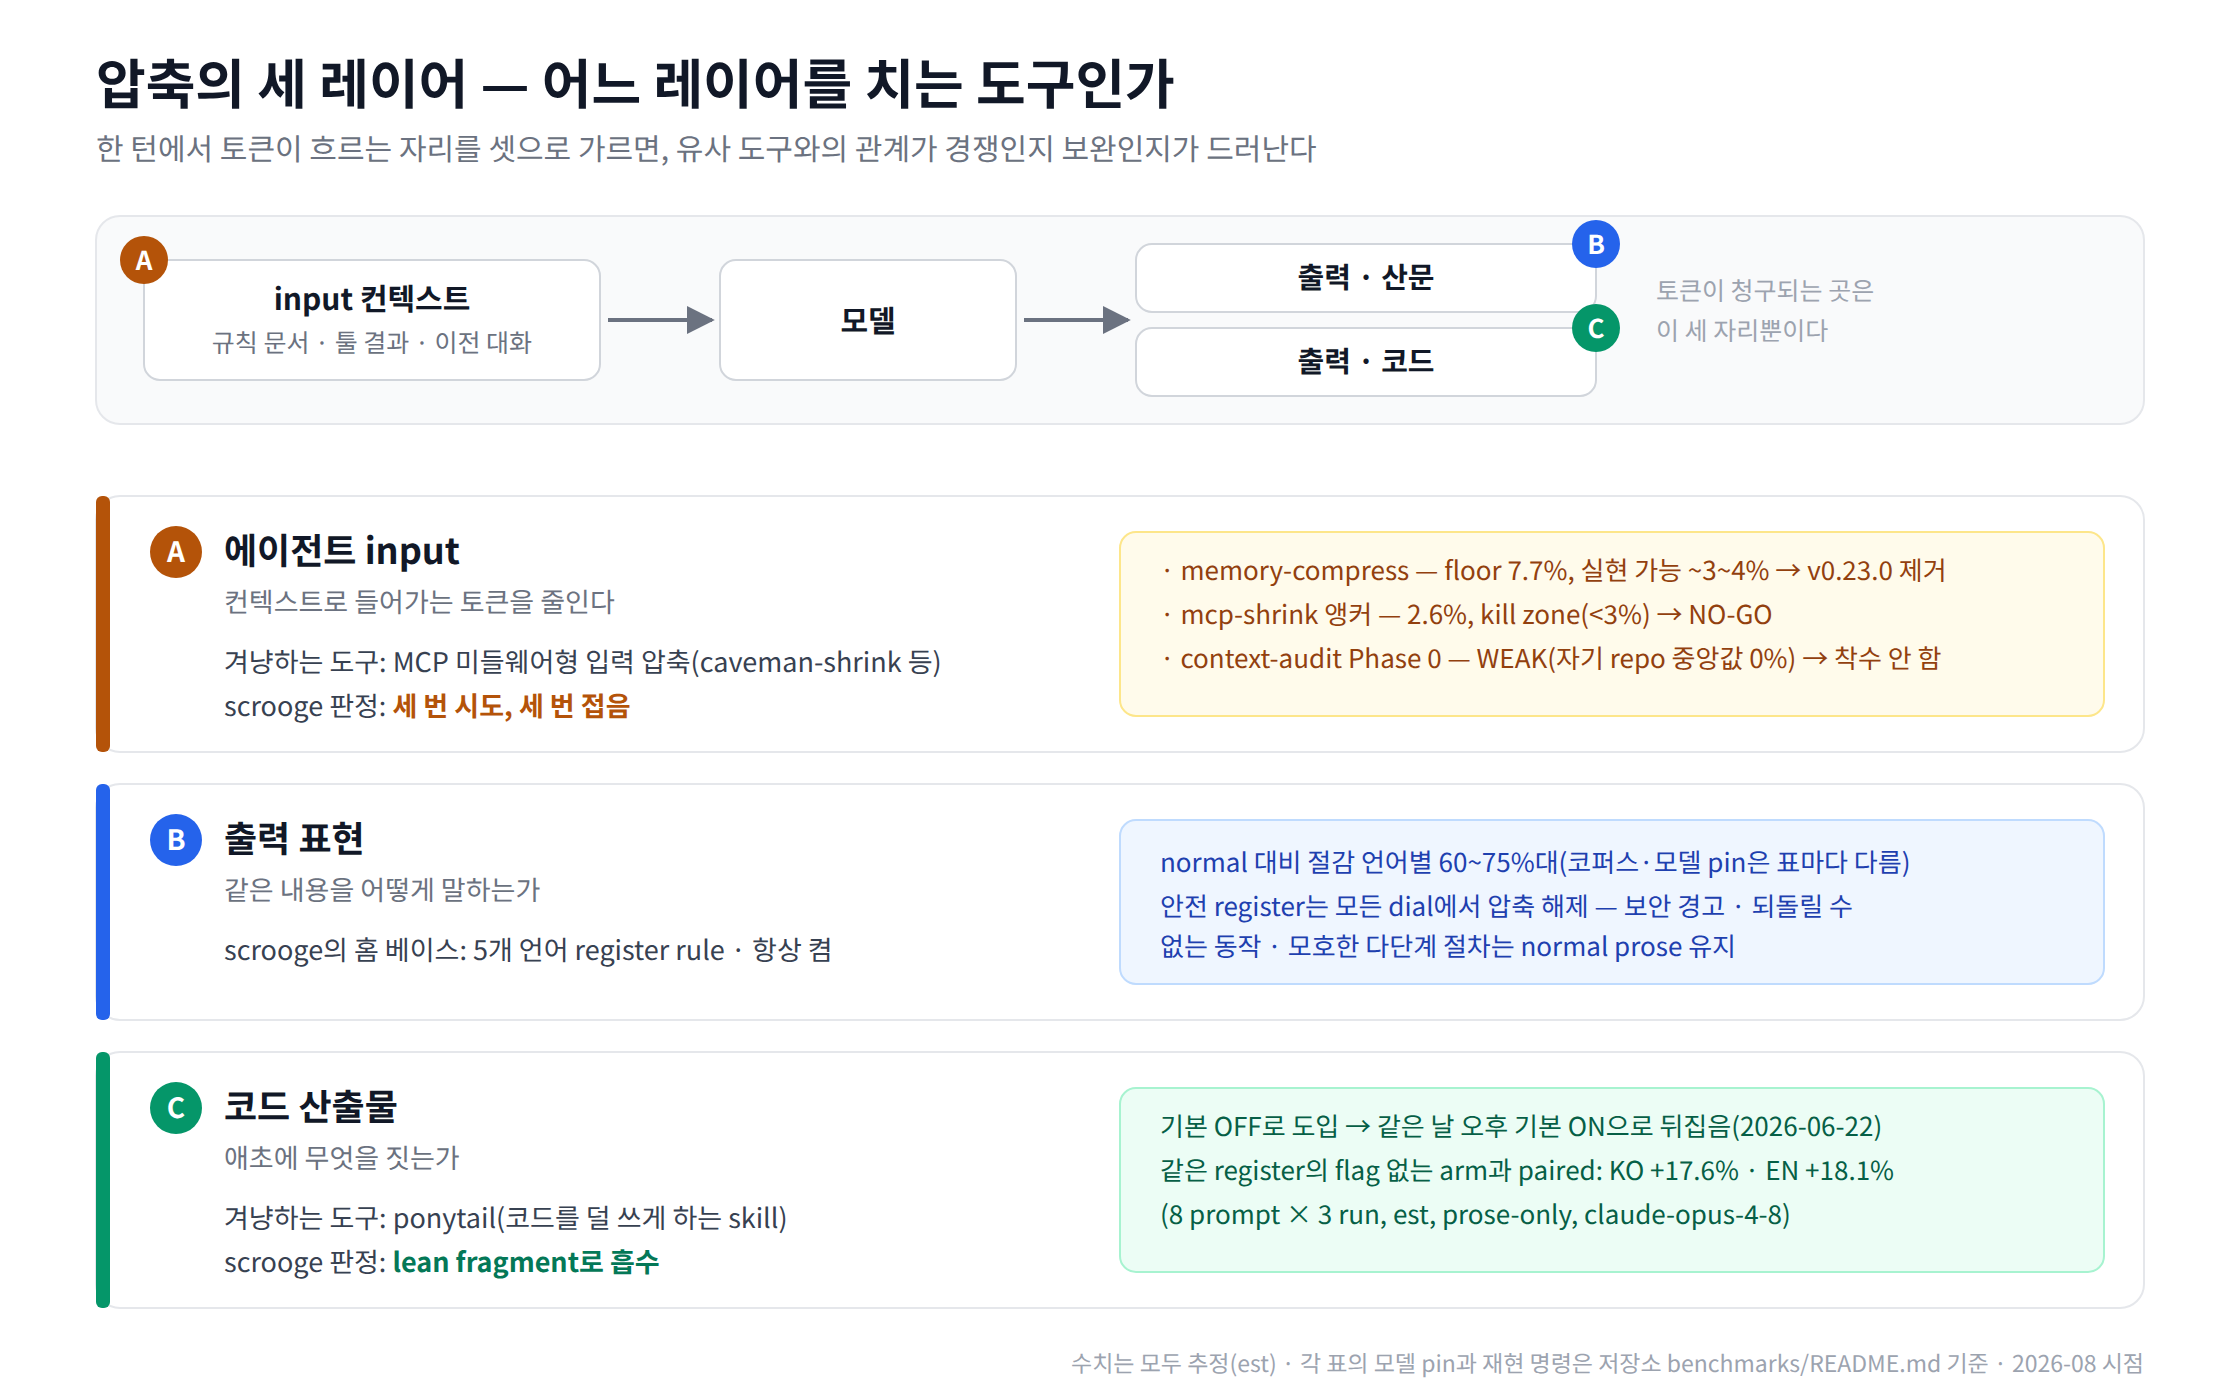
scrooge의 홈은 가운데다. 같은 내용을 어떻게 말하는가 — 개조식, 존댓말 제거, 서두 제거. 한국어 1순위로 설계한 register 규칙이 제품의 본체고, 언어별로 normal 대비 60~75%대 절감이 붙는다(코퍼스와 모델 pin은 표마다 다르다). ponytail은 세 번째 층, 코드 산출물에 서 있다. caveman-shrink 같은 MCP 미들웨어는 첫 번째 층, input이다.
세 도구가 같은 층에서 부딪히는 게 아니라 각자 다른 층에 서 있다는 게 지도의 결론이었다. 남은 판단은 둘. 몇 개의 층을 감당할 것인가, 그리고 남의 층에 발을 들일 때 어떻게 들일 것인가.
input 레이어는 이미 세 번 쳐보고 세 번 접었다
첫 번째 층은 매력적이다. 매 세션 주입되는 규칙 문서, 툴 결과, 이전 대화 — 눈에 보이게 크다. 그래서 이미 세 번 갔다.
memory-compress는 CLAUDE.md·AGENTS.md를 입력 쪽에서 줄이는 opt-in CLI였다. 자체 측정에서 floor 7.7%, 보호 구간(코드·경로·URL·보안 문구)을 빼면 실제 realize 되는 몫은 3~4%대. 그 수치와 prompt cache 요금 구조를 함께 놓고 보니 표면을 유지할 값어치가 없었고, v0.23.0에서 지웠다. 같은 계열의 MCP 축소 접근을 잰 값 2.6%는 우리가 스스로 정해 둔 kill zone(3% 미만)에 들어가 앵커로만 남았다.세 번째가
context-audit이다. "주입되는 문서에서 기계적으로 지울 수 있는 낭비가 몇 %인가"를 LLM 없이 결정론적으로 재는 Phase 0 게이트를 짰다. 중복 블록, 죽은 규칙(끊긴 경로 참조·TBD마커), 저밀도 산문 세 범주. 합성 픽스처는 중앙값 28.22%로 GO 문턱(8%)을 여유 있게 넘겼는데, 정작 우리 저장소의 실제 주입 문서 네 개는 중앙값 0%였다. 이미 dogfood로 조여 놓은 문서에는 지울 게 없었다.두 값이 갈리면 어느 쪽도 대표값이 아니다. 판정은
WEAK— GO가 아니다. 기능은 착수하지 않았고, 하네스 코드는 지우되 측정 결과 파일은 남겼다. 근거를 지운 판정은 판정이 아니라 주장이 된다.그러니 "우리는 input을 안 건드린다, 보완재다"는 포지셔닝 수사가 아니다. 세 번 재고 세 번 접은 결과를 문장으로 옮긴 것뿐이다. 측정 없이 말했다면 그냥 겸손한 척이었을 거다.
코드 레이어는 베끼는 대신 fragment로 붙였다
세 번째 층은 달랐다. 여기는 실제로 출력이고, 우리가 이미 규칙 텍스트로 모델 행동을 바꾸고 있는 바로 그 표면이다. 기능을 통째로 이식할 게 아니라 축을 하나 더 여는 문제였다.
dial(압축 강도)과 직교하는 flag 축을 만들었다. lang × dial이 base 규칙 파일을 고르고, 활성 flag가 각자의 fragment를 그 뒤에 이어 붙인다. 매핑은 registry에 데이터로만 추가한다.
// registry.json — 언어 × dial 1:1 매핑 옆에 fragments 서브트리를 둔다.
// 여기에 한 줄 추가하는 것 외에 hook 코드는 손대지 않는다.
{
  "ko": { "full": "rules/ko/full.md" },
  "en": { "full": "rules/en/full.md" },
  "fragments": {
    "ko": { "lean": "rules/ko/fragments/lean.md" },
    "en": { "lean": "rules/en/fragments/lean.md" }
  }
}
// 주입 본문 = base 규칙 + 활성 flag의 fragment들을 순서대로 이어 붙인 것. // registry는 한 번만 읽는다. function assembleRuleBody(repoRoot, lang, dial, flags = []) { const reg = loadRegistry(repoRoot); if (!reg) return null; const baseRel = reg[lang] && reg[lang][dial]; if (typeof baseRel !== 'string') return null; // 미등록 조합 → 주입 없음 const base = readRuleBody(path.join(repoRoot, baseRel)); if (!base) return null; // edge case: fragment는 선택 사항이다. // 매핑이 없거나(파일이 생기기 전에 flag가 켜진 상태로 저장된 경우) // 읽기에 실패하면 그 flag만 건너뛴다 — 주입 전체가 실패하는 대신 // base 규칙만으로 degrade한다. 압축이 덜 되는 건 버그지만, // 규칙이 통째로 안 들어가는 건 사고다. const fragMap = (reg.fragments && reg.fragments[lang]) || {}; const parts = [base]; for (const flag of flags) { const rel = fragMap[flag]; if (typeof rel !== 'string') continue; const frag = readRuleBody(path.join(repoRoot, rel)); if (frag) parts.push(frag); } return parts.join('\n\n'); }명령 파싱도 축만 하나 늘렸다.
/scrooge ko full lean,/scrooge nolean— 순서는 무관하고, 모르는 토큰은 무시한다.// flag는 lang/dial과 직교하는 가산 축. `lean`은 켜고 `nolean`은 끈다. const addFlags = []; const removeFlags = []; for (const a of args) { if (VALID_FLAGS.includes(a)) addFlags.push(a); else if (a.startsWith('no') && VALID_FLAGS.includes(a.slice(2))) { removeFlags.push(a.slice(2)); } } // edge case: 모든 토큰이 어느 축에도 안 걸리면(`/scrooge bogus`) // 상태를 건드리지 않는다. 오타 하나로 남의 세션 설정을 조용히 // 덮어쓰는 게 제일 나쁜 실패다. if (!lang && !dial && addFlags.length === 0 && removeFlags.length === 0) { return null; }VALID_FLAGS는 화이트리스트다. 상태 파일은~/.claude밑 예측 가능한 경로에 있으니, 심어 둔 값이 다음 턴에 모델 컨텍스트로 주입될 수 있다. 목록 밖 토큰은 저장도 주입도 되지 않는다.기본 OFF는 반나절을 못 버텼다
처음 내린 결정은 명확했다. lean은 opt-in으로만 낸다. 논리는 이랬다 — scrooge가 파는 건 "출력 표현만 건드린다, 답의 내용은 안 바꾼다"는 계약이다. 코드 다이어트를 기본으로 켜면 도구가 결과물의 내용을 바꾸기 시작하고, 그 순간 셀링포인트가 무너진다. 안전을 위해 의도적으로 꺼 둔 채 내는 게 옳다고 봤다.
6월 22일 오전 10시 반에 flag 축과 lean fragment를 기본 OFF로 넣었다. 그리고 같은 날 오후 3시 15분, 기본 ON으로 뒤집었다. 네 시간 반이다.
그 사이에 바뀐 건 두 가지다.
하나, 계약을 지키는 건 flag의 기본값이 아니라 fragment 안의 안전 바닥이었다. 기본값은 사용자가 언제든 바꾸지만 계약은 규칙 텍스트가 지킨다. fragment 마지막 문단을 계약문으로 다시 썼다.
lean에서도 절대 양보 금지: 정확성, 입력 검증, 에러 처리, 보안 점검,
작업이 요구하는 테스트. lean은 범위·재발명·해설·장황함만 줄이고
안전·필수 동작은 줄이지 않음. 보안 경고·되돌릴 수 없는 동작 절차는
normal prose 유지.
하나 더 박았다. "침묵하며 적용" — 최소 해법만 내놓고 어떻게 줄였는지 해설하지 말 것. 버린 대안 나열, 라이브러리 대 직접구현 비교, "이렇게도 가능합니다" 금지. 최소 출력이지 최소주의 해설이 아니다. 압축 도구가 압축 과정을 설명하느라 토큰을 더 쓰는 건 웃기는 실패이고, 초안에서 그게 났다.
둘, 재 보니 공짜가 아니었다. flag는 dial이 아니므로 A/B 기준선은
normal이 아니라 같은 register의 flag 없는 arm이다. 과설계를 유도하는 코드 과제 코퍼스를 따로 만들고 8개 프롬프트 × 3회를 paired로 돌렸다.register 프롬프트 × 실행 절감 중앙값 95% CI sign test scrooge:ko/full+lean8 × 3 +17.6% +10.2 ~ +43.7% p=0.0015 scrooge:en/full+lean8 × 3 +18.1% +10.7 ~ +28.3% p=0.012 추정치이고, prose-only 집계이며,
claude-opus-4-8기준이다. 두 CI 모두 0을 제외하고 sign test도 통과하니 방향은 확정. 다만 구간이 넓고 한국어 쪽은 치우쳐 있어 "대략 5분의 1, 방향은 확실하고 크기는 헐겁다"로 읽어야 맞다. 재현은report.py --baseline scrooge:{ko,en}/full --paired --drop-tool-rows.기본을 뒤집은 근거는 이 표지 "경쟁 도구가 켜져 있으니까"가 아니다. 순서가 반대였으면 그건 그냥 카피다.
같이 넣은 플래그 둘은 그날 저녁에 지웠다
축을 연 김에 셋을 달았다.
lean말고ctx(낭비적 파일 재읽기·drip-feed read를 줄이는 컨텍스트 절약)와max(최대 압축).ctx는 그날 저녁 지웠다. 측정에서 절감이 잡히지 않았다. 돌이켜보면 당연한데,ctx는 결국 input 레이어를 규칙 텍스트로 치겠다는 시도였고 그건 위에서 세 번 접은 바로 그 층이다.max는 lean이 단독으로 서면서 의미가 없어져 같이 지웠다.축을 만든 날 순증은 셋이 아니라 하나였다. 축을 여는 일의 성공은 많이 다는 게 아니라, 달아보고 안 걸리는 걸 그날 안에 떼는 것이었다.
그 +18%도 한 번은 틀린 숫자였다
v0.22.1까지 발표한 lean 수치는 KO +34.6% / EN +10.3%였다. 24pp나 벌어진 두 언어를 두고 "한국어에서 훨씬 잘 듣는다"는 해석까지 붙여 뒀다. 둘 다 틀렸다.
새로 측정한 게 아니라 기존 행을 다시 유도하다 나왔다. 하나, 구조를 표본 크기로 착각했다. 코퍼스는 8 프롬프트 × 3 실행인데 발표문은 paired 키 개수 21·22를 독립 프롬프트 수인 양 인용했다 — 부트스트랩은 상관된 21쌍이 아니라 8개 프롬프트를 재표집해야 한다. 둘, 툴을 쓴 행 하나가 추정을 지배했다. 영어 파일에서 flag 없는 기준선 한 셀이 툴로 답해 prose 119 토큰·툴 7,645 토큰을 남겼고, prose-only로 비교하니 멀쩡한 인라인 답변이 껍데기와 붙어 버렸다. 한국어 파일엔 그 거울상이
+lean쪽에 있었다.바로잡으니 두 언어가 0.5pp 안으로 모였다. 24pp 차이는 현상이 아니라 아티팩트였다. 8월 6일에 문서를 정정하면서 옛 수치도 왜 틀렸는지와 함께 남겼다.
압축 도구가 파는 건 절약 수치이고, 그러면 수치의 정직성이 곧 제품 품질이다. 경쟁 도구가 나왔을 때 제일 위험한 건 저쪽 기능을 못 따라가는 게 아니라, 급해져서 내 숫자를 덜 의심하게 되는 쪽이다.
정리
경쟁 도구는 기능 목록으로 만나면 카피 로드맵이 되고, 레이어로 만나면 지도가 된다. 남의 층에 발을 들일 땐 기능을 이식하지 말고 축을 하나 열되, 측정에 안 걸리는 건 그 주에 떼라. 기본값을 뒤집을 근거는 경쟁자가 아니라 페어링 된 A/B 표다.
지금 만드는 도구가 있다면, 기능 비교표를 열기 전에 종이에 층부터 그어 보라.
어느 표면을 책임질지 먼저 긋고, 경계 안의 계약을 텍스트로 못 박고, 바꿀 땐 측정으로 바꾼다 — 컴포넌트 API를 설계할 때 하던 일과 다르지 않았다. 인터페이스를 다루는 craft는 상대가 사람이든 에이전트든 하나다.
참고
- ponytail — 에이전트가 코드를 덜 쓰게 하는 Claude Code skill. 사다리 방식과 절감 수치는 그 프로젝트 자신의 발표 기준이다: github.com/DietrichGebert/ponytail
- 본문의 절감·fidelity 수치, 모델 pin, 재현 명령은 모두 scrooge 저장소
benchmarks/README.md와benchmarks/context-audit/기준이며 2026년 8월 시점이다: github.com/Kir93/scrooge-mode - 모든 절감 수치는 추정(est)이다. 프롬프트마다 압축률이 다르고 같은 arm도 실행 간 변동이 크다(한 셀 안 output token 변동 중앙값 20~29% CV).
반응형'AI 엔지니어링' 카테고리의 다른 글
토큰은 돈이다 시즌2 1편 - 압축 도구가 자기 벤치마크의 baseline까지 압축한 작업기 (0) 2026.10.20 토큰은 돈이다 시즌2 0편 - 출시하자마자 내 숫자 세 개가 전부 틀렸다 (0) 2026.10.13 멀티에이전트 ideation으로 뽑은 흡수 후보 7개 중 3개를 지운 작업기 (0) 2026.10.06 LLM 출력 압축에 문서 경계를 그은 작업기 (0) 2026.09.29 심링크에서 복사로 후퇴한 세 번의 작업기 (0) 2026.09.22