-
토큰은 돈이다 시즌2 0편 - 출시하자마자 내 숫자 세 개가 전부 틀렸다AI 엔지니어링 2026. 10. 13. 07:22728x90반응형
stats는 2.89배로 부풀고, 벤치는 내 훅에 오염되고, README는 재본 적 없는 정확도를 광고하고 있었다
출시하고 제일 먼저 한 일은 내 도구를 나한테 써보는 거였다. 압축 모드를 켜고 하루를 보낸 뒤
/scrooge-stats를 쳤다. 절감량이 체감보다 컸다. 압축 도구가 파는 건 결국 숫자 하나뿐이라 그 숫자가 크게 나오면 기뻐할 게 아니라 의심해야 한다.세션 트랜스크립트를 직접 세어봤다. 어시스턴트 라인이 385줄인데
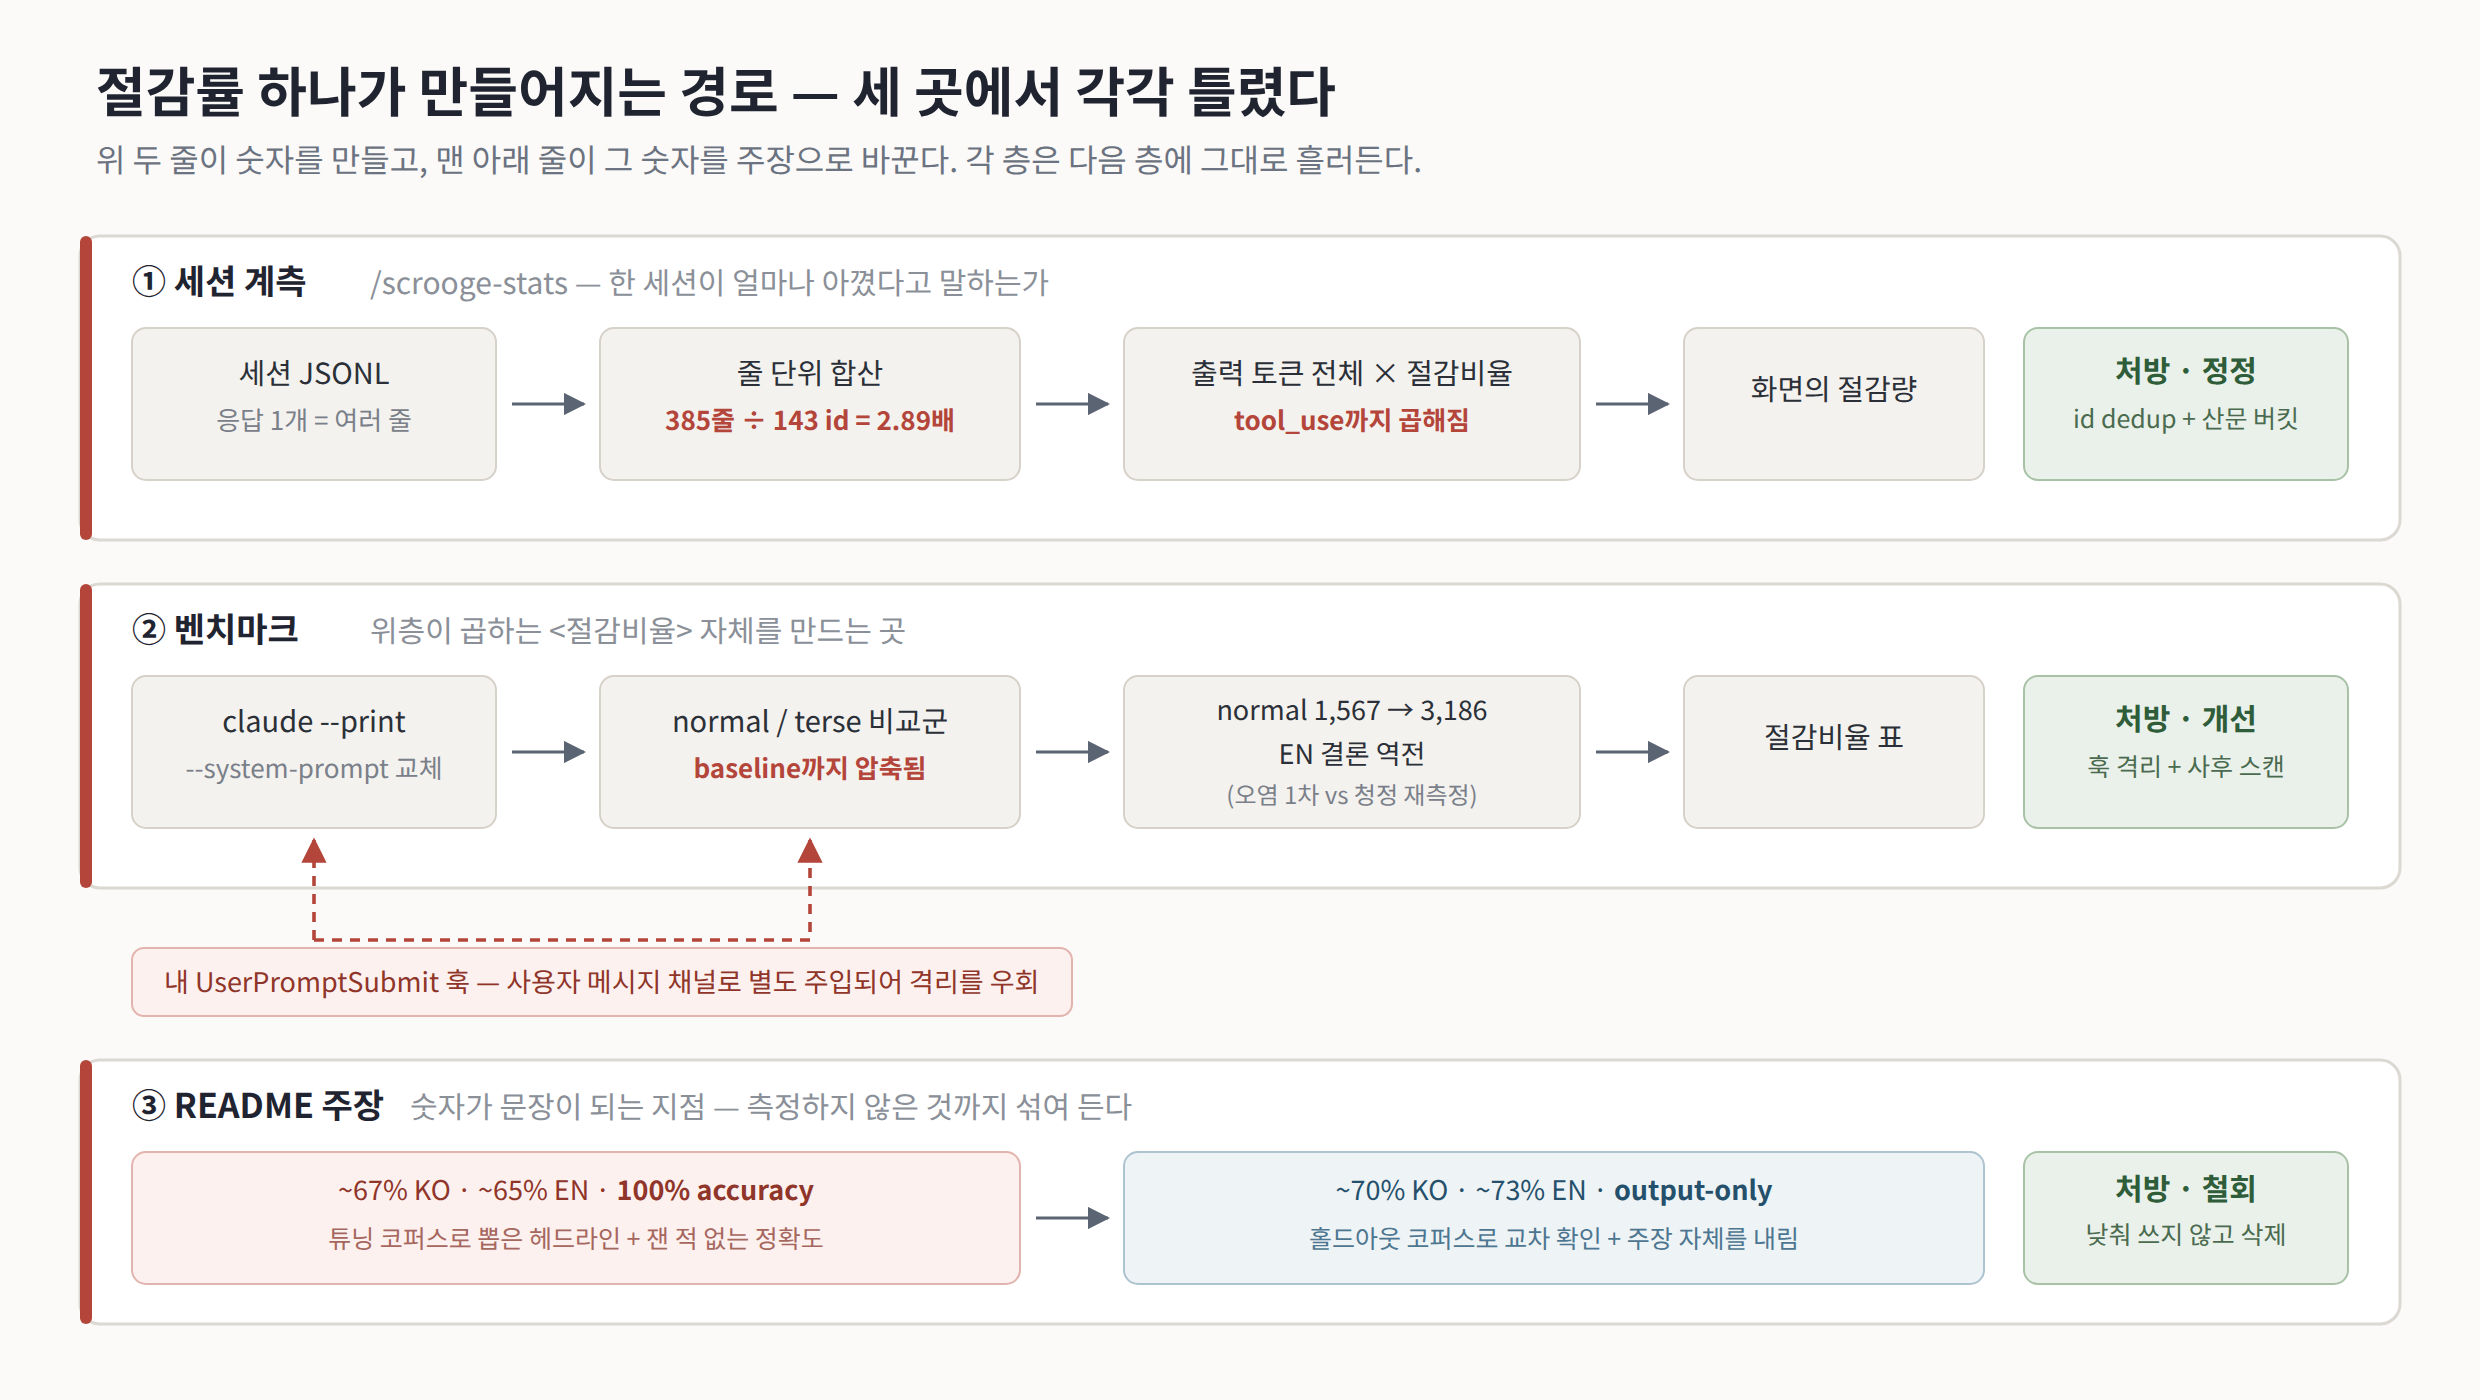
message.id는 143개였다. Claude Code는 응답 하나를 content block마다 한 줄씩 JSONL에 쓰고, 그 줄마다 같은usage객체를 통째로 반복한다. 줄을 전부 더하면 2.89배가 나온다. 내 stats는 첫 커밋부터 그렇게 더하고 있었다.거기서 멈추지 못하고 벤치마크와 README까지 열었다. 셋 다 틀려 있었다. 계측이 부풀었고, 측정이 오염됐고, 문장은 애초에 재본 적 없는 걸 주장했다. 자기 도구의 효과를 퍼센트로 광고해 본 적 있다면 이 글은 어디를 먼저 열어봐야 하는지에 관한 기록이다. (2026년 6월 구현·측정 기준)
고치는 데에도 종류가 있다
작업 목록을 만들다 보니 전부 버그 수정으로 뭉뚱그려지지 않았다. 셋으로 갈랐다.
개선은 동작을 바꾼다. 없던 격리를 넣고, 전역 상태를 세션 단위로 쪼갠다. 정정은 값을 바로잡는다. 계산식이 틀렸으니 다시 계산해 숫자를 갈아 끼운다. 철회는 주장을 지운다. 재본 적 없는 문장에는 고칠 값이 없다. 낮춰 쓸 수도 없으니 지우는 것 말고 할 게 없다.
이 구분이 없으면 철회할 것을 정정으로 처리하게 된다. "100% accuracy"를 "98% accuracy"로 낮추는 식으로. 그건 정직해 보이는 문장을 하나 더 만들 뿐이다.
한 응답이 세 줄이면 세 번 세어진다
계측부터 손봤다.
message.id로 묶고 그 묶음의 usage를 한 번만 센다. 단순해 보이지만 함정이 두 개 있었다.// lib/session-log.js — Claude Code 트랜스크립트(JSONL) → 토큰 요약 // 한 응답이 content block 수만큼 줄로 쪼개져 기록되고, 줄마다 동일한 usage가 // 반복된다. 이 저장소에서 실측: 385줄 / 고유 id 143개 = 2.89배 과다 계상. export function parseClaudeSession(filePath) { const raw = fs.readFileSync(filePath, 'utf8'); const byId = new Map(); let lineIndex = -1; for (const line of raw.split('\n')) { lineIndex++; if (!line.trim()) continue; let entry; try { entry = JSON.parse(line); } catch { continue; } // 깨진 줄은 버린다 if (entry.type !== 'assistant' || !entry.message) continue; const msg = entry.message; // id가 없으면 requestId, 그것도 없으면 줄 번호. 줄 번호 fallback은 // 서로 다른 응답을 절대 합치지 않는다 — 과소 계상보다 과다 계상이 안전하다. const id = msg.id || entry.requestId || `__line_${lineIndex}`; let rec = byId.get(id); if (!rec) { rec = { output: 0, hasUsage: false, hasToolUse: false }; byId.set(id, rec); } if (msg.usage) { // 반복 줄은 동일한 usage를 싣는다. last-wins라 반복에 대해 멱등하다. rec.output = msg.usage.output_tokens || 0; rec.hasUsage = true; } // tool_use 판정은 그 id의 '모든' 줄을 훑은 뒤에 확정한다. text 블록이 // 먼저 스트리밍됐다고 prose로 확정해 버리면 같은 응답을 오분류한다. for (const block of msg.content || []) { if (block?.type === 'tool_use') { rec.hasToolUse = true; break; } } } let prose = 0, toolUse = 0, turns = 0; for (const rec of byId.values()) { if (!rec.hasUsage) continue; if (rec.hasToolUse) toolUse += rec.output; else prose += rec.output; turns++; } return { outputTokens: prose + toolUse, proseOutputTokens: prose, toolUseOutputTokens: toolUse, turns }; }첫 번째 함정은 fallback 설계였다.
message.id가 없는 줄을 어떻게 묶을지 고민하다가 "usage 값이 같으면 같은 응답으로 본다"는 안을 떠올렸다. 그 방향으로 안 갔다. 우연히 같은 토큰 수를 쓴 별개의 응답 둘을 하나로 합치면 계측은 과소로 틀린다. 계측 도구가 틀릴 때는 자기에게 불리한 쪽으로 틀리는 게 낫다. 그래서 id 없는 줄은 줄 번호로 각자 남겨 둔다.두 번째가 더 중요했다. 절감률을 곱하는 대상이 잘못돼 있었다. 압축 register가 깎는 건 사람이 읽는 산문이지, 에이전트가 뱉는 tool_use JSON이 아니다. 그런데 stats는 출력 토큰 전체에 절감률을 곱해 "이만큼 아꼈다"를 만들었다. 에이전틱 세션일수록 tool_use 비중이 커지니 도구를 열심히 쓸수록 절감이 부풀어 보이는 구조였다. 지금은 산문 버킷에만 비율을 적용하고, 화면에 근거를 같이 찍는다.
Output tokens:         12,480
  prose:                4,905
  tool_use:             7,575
──────────────────────────────
Est. without scrooge:  16,350 (prose-only basis)
Est. tokens saved:     11,445 (~70%, est)
Estimate from benchmarks/ (mean per-dial, ko/full); applied to prose output only
— tool_use output excluded. Savings are counterfactual.
압축 도구가 자기 baseline을 압축하고 있었다
벤치마크는 더 나빴다. 내 플러그인 훅이 켜진 상태로 벤치를 돌리고 있었다.
하네스는 각 arm을
claude --print --system-prompt <rule>로 띄운다.--system-prompt는 시스템 프롬프트를 교체하지만UserPromptSubmit훅은 막지 못한다. 훅은 사용자 메시지 채널로 따로 주입되기 때문이다. 그래서 비교군인normal과terse에도 압축 지시가 그대로 들어갔다. 비교 대상이 이미 압축돼 있으니 절감률이 뭉개진다.청정 재측정 전후는 이렇다.
모드 오염된 1차 (N=24) 청정 재측정 (N=20) normal(baseline)1,567 3,186 terse1,145 2,597 scrooge:ko/full511 972 caveman:full901 1,203 baseline이 절반으로 눌려 있었다. 영어 쪽은 결론까지 뒤집혔다. 1차에서는 비교 도구가 396 토큰까지 내려가 "영어는 상대가 더 세다"라고 README에 적었는데, 청정 재측정에서는 1,264 대 969로 우리가 앞섰다. 상대 arm의 출력을 내 훅이 깎아 놓고, 그걸 상대의 실력으로 적어 둔 셈이다.
절감률 자체는 오히려 좋아졌다(KO 약 67% → 약 70%, EN 약 65% → 약 73%). 그래도 1차 결과는 전량 폐기했다. 오염된 측정은 숫자가 유리하게 나왔든 불리하게 나왔든 폐기가 맞다. 유리할 때만 남기면 그건 측정이 아니라 선별이다.
지금은 벤치가 시작 전에 register 상태 파일을 옆으로 치우고, 그러고도 활성 채널이 남아 있으면 실행을 중단한다. 실행 후에는 세션 트랜스크립트마다 훅 주입 흔적을 스캔해 걸린 행을 점수에서 뺀다. 사전 점검은 편의고, 사후 스캔이 실제 보증이다. 오염 경로를 어떻게 재현하고 어떻게 그물을 쳤는지는 다음 편에서 따로 다룬다.
재본 적 없는 문장은 지우는 수밖에 없다
README 상단에는 이렇게 적혀 있었다.
- **`~67% KO · ~65% EN · 100% accuracy · honorifics stripped`** — `claude-opus-4-7`, N=24 paired median.
+ **`~70% KO · ~73% EN · output-only · honorifics stripped`** — `claude-opus-4-8`, N=20–21 paired median.
퍼센트는 정정이다. 다시 재서 갈아 끼웠다.
100% accuracy는 다르다. 나는 정확도를 한 번도 측정한 적이 없다. 압축 대상이 출력 표현이지 내용이 아니라는 설계 의도를 성과처럼 적어 둔 문장이었다. 낮춰 쓸 값이 없으니output-only로 바꿔 주장 자체를 내렸다.같은 작업에서 코퍼스도 갈랐다. 그전까지는 규칙을 튜닝한 그 프롬프트 세트로 헤드라인 숫자를 뽑았다. 지금은 튜닝용과 리포트용을 분리하고, 규칙은 리포트 세트에 절대 맞추지 않는다. 홀드아웃으로 다시 재니 KO 약 71%, EN 약 68%(각 N=11)로 헤드라인과 붙었다. 과적합이 아니라는 확인은 이렇게밖에 못 한다.
전역 스위치를 세션 스위치로
숫자를 손보는 동안 상태 설계도 같이 갈아엎었다. 시즌1 4편에서 "이건 함정"이라고 써 놓고 그대로 둔 것이 하나 있었다. 활성 상태가
~/.claude/.scrooge-active파일 하나였다. 세션 A에서 끄면 세션 B도 꺼졌다.세션 키로 파일을 쪼개는 건 어렵지 않다. 어려운 건 기존 전역 상태를 어떻게 처리하느냐였다.
// hooks/scrooge-config.js
// 세션 키는 파일명에 그대로 들어간다. session_id는 호스트가 주는 값이라
// 경로 구분자나 '..'가 섞이면 임의 경로 쓰기가 된다. 화이트리스트로 깎고
// 길이를 자른 뒤, 남는 게 없으면 null(= 전역 fallback).
export function sanitizeSessionKey(raw) {
  if (typeof raw !== 'string') return null;
  const cleaned = raw.replace(/[^A-Za-z0-9_-]/g, '').slice(0, 64);
  return cleaned.length > 0 ? cleaned : null;
}

export function getStatePath(sessionKey) {
  // 키가 있으면 세션별 파일, 없으면(세션 개념이 없는 호스트) 기존 전역 파일.
  return path.join(claudeDir(), sessionKey ? `.scrooge-active-${sessionKey}` : '.scrooge-active');
}
처음엔 업그레이드 시점의 전역 값을 각 세션으로 승격시키려 했다. 켜 둔 사람이 다시 켜야 하는 게 싫었으니까. 그런데 저 전역 경로는 세션 개념이 없는 호스트의 fallback으로 계속 살아 있다. 승격을 넣으면 그 값이 이후 모든 새 세션으로 새어 들어간다. 고치려던 격리 버그가 마이그레이션 코드 안에서 그대로 재현된다. 그래서 승격을 버리고 무시를 골랐다. 업그레이드 직후 한 턴은 꺼진 것으로 보인다. 사용자는
/scrooge를 한 번 더 친다. 한 번의 불편이 영구적인 상태 누수보다 싸다.세션이 재개될 때 압축 register가 새 컨텍스트 창에서 사라지는 문제는
SessionStart훅에서 규칙 전문을 재주입해 막았다. 같은 훅이 14일 지난 세션 상태 파일을 쓸어낸다. 세션마다 파일이 하나씩 생기는 설계라 청소를 같이 넣지 않으면 홈 디렉터리가 쓰레기통이 된다."끄는 법 설명해 줘"가 모드를 껐다
자연어 활성화에도 같은 종류의 버그가 있었다. 이 저장소에서 작업하다 보면 스크루지 얘기를 종일 한다. 그러다 "스크루지 모드 끄는 로직 설명해 줘"라고 물으면 훅이
끄를 잡아 모드를 껐다. 도구를 두고 말하는 것과 도구를 부리는 것을 가르지 못했다.// hooks/nl-activation.js const SCROOGE_NAME = /스크루지|scrooge/i; // 메타질문 신호. 활성화/해제 표현과 겹치지 않게 고른다 — '꺼', 'off', 'enable' // 같은 명령 어휘는 이 목록에 없어야 진짜 명령을 취소하지 않는다. const META_CUE = /설명|로직|버그|동작|작동|어떻게|원리|의미|무엇|무슨|\b(?:explain|logic|bug|debug|how|what|why|mean(?:s|ing)?)\b/i; // 다만 스타일 지시는 메타 신호가 같이 있어도 진짜 활성화다. // "스크루지처럼 설명해줘"는 답변을 그 문체로 달라는 요청이지 질문이 아니다. const STRONG_STYLE = /스크루지\s*(?:처럼|로\s*(?:답|말|얘기|대답))|\btalk\s+like\s+(?:a\s+)?scrooge\b/i; export function parseNaturalActivation(prompt) { const text = String(prompt || ''); if (!text) return null; // 모드에 '대한' 질문은 활성화도 해제도 아니다 — 아무것도 하지 않는다. if (SCROOGE_NAME.test(text) && META_CUE.test(text) && !STRONG_STYLE.test(text)) return null; // ... 이하 기존 활성화/해제 판정 }가드에는 반대 방향 실패가 따라온다. 메타 신호만 보고 전부 무시하면 "스크루지처럼 설명해 줘"까지 죽는다. 그래서 두 케이스를 한 쌍으로 테스트에 박았다. 오발을 막는 규칙에는 항상 과잉 억제 테스트가 따라붙어야 한다.
test('모드에 대한 메타질문은 토글하지 않는다', () => {
  for (const p of ['스크루지 모드 끄는 로직 설명해줘', 'explain scrooge mode off',
                   '스크루지 모드 버그', 'how does scrooge mode work']) {
    assert.equal(parseNaturalActivation(p), null, p);
  }
});

test('메타 신호가 있어도 스타일 지시는 활성화된다', () => {
  assert.deepEqual(parseNaturalActivation('스크루지처럼 설명해줘'), { action: 'set', lang: 'ko', dial: 'full' });
  assert.deepEqual(parseNaturalActivation('talk like scrooge and explain this'), { action: 'set', lang: 'en', dial: 'full' });
});
도구가 광고하는 숫자는 계측·측정·주장 세 곳에서 각각 틀리고, 셋은 서로를 가려 준다. 고치기 전에 개선·정정·철회를 가른다. 재본 적 없는 주장은 낮춰 쓰는 게 아니라 지운다. 오염된 측정은 결과가 유리하게 나왔더라도 폐기한다. 유리할 때만 남기면 측정이 아니라 선별이다.
지금 쓰는 도구의 README에서 숫자가 들어간 문장을 하나 골라, 그 값을 실제로 만들어 낸 코드 경로를 끝까지 따라가 보라.
2026.06.08 - [AI 엔지니어링] - 토큰은 돈이다 — 한국어를 위한 LLM 출력 압축 도구 (Scrooge 0편)
반응형'AI 엔지니어링' 카테고리의 다른 글
멀티에이전트 ideation으로 뽑은 흡수 후보 7개 중 3개를 지운 작업기 (0) 2026.10.06 LLM 출력 압축에 문서 경계를 그은 작업기 (0) 2026.09.29 심링크에서 복사로 후퇴한 세 번의 작업기 (0) 2026.09.22 골든셋·headless runner로 LLM 판정 게이트 회귀 테스트 작업기 (0) 2026.09.15 멀티프로젝트 Claude Code 설정 운영기 5편 - 30k 깎을 계획으로 시작해 6.3k에서 멈춘 이유 (0) 2026.09.08