-
LLM 출력 압축에 문서 경계를 그은 작업기AI 엔지니어링 2026. 9. 29. 07:15728x90반응형
README를 써달라고 했더니 ~함 종결로 나왔다
출력 토큰을 깎는 register 규칙을 만들어 쓴다. 존댓말을 떨어뜨리고,
~함으로 끝내고, 의미가 명확하면 조사를 생략하는 식이다. 대화에서는 잘 맞았다. 답을 읽고 나면 버리는 표면이라 어조를 깎아도 손해가 없었다.문제는 그 다음이었다. 한 세션에서 README의 설치 섹션을 써달라고 했더니 이런 게 나왔다.
Node 18+ 필요. 설치 `npm i taskline`. 초기화 `npx taskline init` 실행 시
`taskline.config.json` 생성됨. 환경변수 `TASKLINE_TOKEN` 필수 — 없으면 기동 실패.
정보는 다 있다. 그리고 이대로 저장소에 커밋할 수는 없다. README는 내가 읽고 버리는 답변이 아니라 처음 오는 사람이 읽는 문서다. 대화 register를 문서에 그대로 흘려보낸 게 문제였다.
새 dial을 하나 만들면 될 것 같았다
이 프로젝트의 규칙은
registry.json이언어 × dial을 규칙 파일 경로에 1:1로 매핑한다. dial은 압축 강도를 고르는 축이다. 구조가 이렇게 생겼으니docdial을 하나 더 얹는 게 가장 자연스러워 보였다. 언어마다 문서용 규칙 파일을 하나씩 두고 문서를 쓸 때만 그쪽으로 전환하면 된다.며칠 붙잡고 있다가 접었다. 두 가지가 걸렸다.
우선 dial은 사용자가 고르는 축이다. 그런데 지금 쓰는 게 대화 답변인지 영속 문서인지는 사용자가 고르는 게 아니라 산출물이 결정한다. 사용자가 README를 쓸 때마다
/scrooge ko doc을 먼저 입력해야 한다면 그건 기능이 아니라 숙제다. 잊어버리는 순간~함종결 README가 다시 나온다.원가도 생각보다 비쌌다. 5개 언어니까 규칙 파일 5개가 새로 생기고,
언어 × dial테스트 매트릭스가 2배가 되고, README·CONTRIBUTING·벤치 문서의 모든 표에 열이 하나씩 붙는다. 이건 추정이 아니라 나중에 값을 치러본 숫자다. 뒤이어litedial을 제거할 때 정확히 그만큼을 되돌려야 했다.lite는 측정이 기각했다.ko/lite는 normal 대비 43.8% 절감에 충실도 0.650,ko/full은 충실도 0.690. 덜 줄이면서 덜 보존하는 파레토 손해였다. 그때 쓴 주석을 그대로 옮기면 이렇다.// hooks/scrooge-config.js // `lite` shipped through v0.22.1 and was removed in v0.23.0. Its own measurement // rejected it: ... it compressed LESS than full and preserved LESS, a Pareto loss // on both axes. Keeping a dial we measured and did not adopt cost five rule files, // half of every language x dial test matrix, and a column in every doc surface. export const VALID_DIALS = ['full'];측정으로 dial 하나를 지워본 뒤에 보니, 측정도 없이 dial 하나를 더 만들려던 계획은 방향이 반대였다.
어조가 아니라 정보 없는 토큰을 깎는다
접고 나서 질문을 바꿨다. 문서를 얼마나 압축할지가 아니라, 문서에서 깎아도 되는 게 정확히 뭔지를 물었다.
답은 어조가 아니었다. 문서에서 낭비되는 토큰은 대부분 정보가 0인 토큰이다. "이 문서는 ~를 설명합니다"로 시작하는 메타 프롤로그, 섹션마다 반복되는 한 줄 intro, "결론적으로 / 요약하면", 본문을 그대로 되풀이하는 요약표, 목적 없는 마크다운 장식. 이것들은 지워도 독자가 잃는 게 없다. 반대로 존댓말과 완전한 문장은 지우면 문서가 아니게 된다.
그래서 새 dial 대신 기존 규칙 파일의
## Boundaries에 항목을 하나 더 넣었다. 경계는 3 분류가 됐다.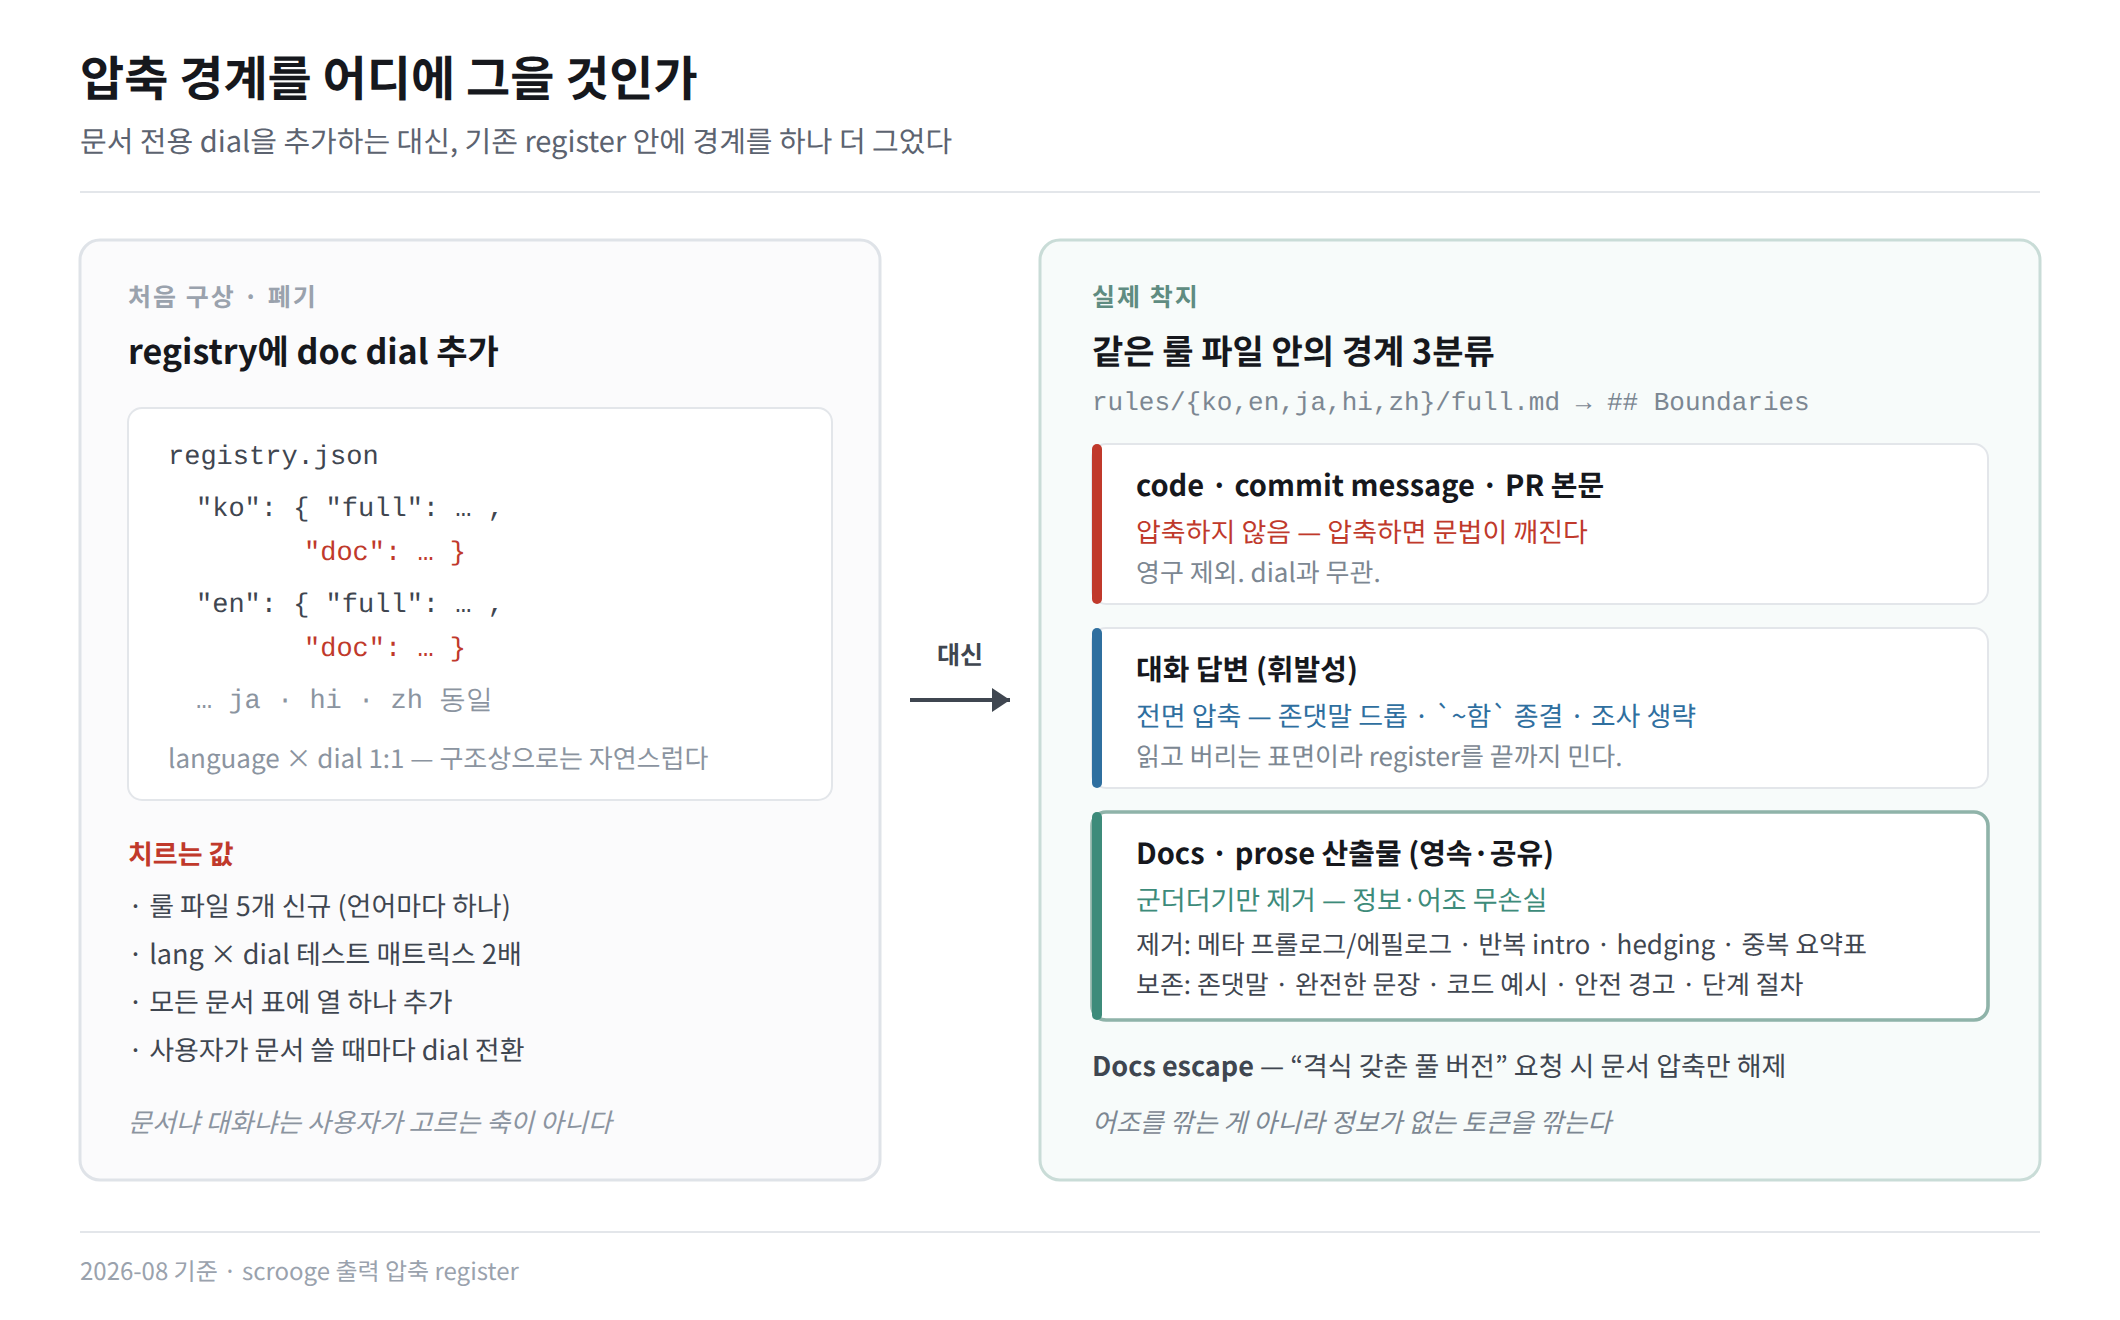
규칙 본문은 이렇게 들어갔다. 다른 register 규칙에 그대로 옮겨 쓸 수 있는 형태다.
## Boundaries

- **Code, commit messages, PR descriptions**: write normally — 압축 = 문법 깨짐. 영구 제외.
- **Docs·prose 산출물** (생성하는 README·기능 명세·보고서·설명 문서): 압축 적용 —
  군더더기만 제거, 정보·어조 무손실.
  - 제거: 메타 프롤로그/에필로그("이 문서는 ~를 설명합니다", "결론적으로", "요약하면"),
    섹션마다 반복되는 intro 한 줄, hedging·정중 완충어, 본문과 중복인 요약표,
    과한 마크다운 장식.
  - 보존: 어조·존댓말·가독성(대화 register의 `~함` 종결·조사 드롭은 문서에 적용 안 함),
    정보·코드 예시·안전 경고·단계 절차.
한 줄이 이 규칙의 전부를 결정한다 —
대화 register의 ~함 종결·조사 드롭은 문서에 적용 안 함. 압축을 끄는 게 아니라 대화용 어조 규칙만 문서에서 뺀다.여기에 탈출구를 하나 붙였다. 사용자가 "격식 갖춘 풀 버전"이나 "외부 공유용 정식 문서"를 명시적으로 요구하면 문서 압축만 해제한다. 대화 답변 압축과는 별개로 동작하므로, 정식 문서 하나를 받자고 세션 전체의 register를 끄지 않아도 된다.
파일로 써버리면 압축률이 조작된다
규칙을 넣었으니 측정할 차례였다. 대화용 코퍼스와 별개로 문서 생성 전용 held-out 코퍼스를 만들었다. 각 줄이 문서 하나를 생성시키는 과제고, 전달할 사실은 프롬프트에 못 박아 뒀다. 그래야 각 arm이 같은 정보를 전달하고 변수는 register만 남는다.
릴리스 노트를 작성해줘. `taskline` v2.3.0. 변경 6개 — feat: 반복 작업 지원,
feat: CSV 내보내기, fix: 자정 넘긴 마감 타임존 버그, fix: 빈 제목 작업 충돌,
perf: 목록 렌더 2배 개선, chore: Node 16 지원 종료.
각 항목을 사용자 영향 기준으로 그룹핑.
첫 실행 결과가 좋았다. 좋아서 의심스러웠다. 로그를 열어 보니 압축 arm이 문서를 파일로 쓰고 있었다.
Write도구를 호출해서release-notes.md를 만든 다음 산문으로는 "작성함" 한 줄만 뱉는다. 내가 세는 건 산문 토큰이니까 압축률이 90%대로 찍힌다. register가 잘한 게 아니라 도구를 쓴 것뿐이다.그래서 파일 변경 도구를 전부 막았다.
python3 benchmarks/run.py \
  --prompts benchmarks/prompts/ko-docgen.txt \
  --arms normal,terse,scrooge:ko/full \
  --disallow-tools \                        # Write/Edit/NotebookEdit/Bash 차단
  --runs 1 --workers 4 --timeout 600 \
  --model claude-opus-4-8 --resume \
  --cwd /tmp/scrooge-clean \                # 호스트 CLAUDE.md 오염 차단
  --output benchmarks/results-ko-docgen.jsonl
두 번째 함정은
--cwd쪽이었다. 문서 생성 프롬프트는 대화 프롬프트와 달리 호스트의~/.claude/CLAUDE.md를 결과물에 그대로 베껴 넣는다. "이 언어로 답하라" 같은 지시가 verbose arm에만 얹히면서 baseline이 부풀고 절감률은 공짜로 커진다. 공개한 실행은 호스트 메모리 파일을 아예 옆으로 치우고 빈 작업 디렉터리에서 돌렸다. 하네스는 register 훅만 격리할 뿐 이건 자동으로 해주지 않는다. 실행할 때마다 손으로 준비했다.퍼센트보다 승률이 정직하다
정리된 수치는 이렇다. 2026년 8월 기준이고,
claude-opus-4-8단일 실행에 산문 토큰만 집계했다.언어 normaltersescrooge프롬프트당 절감 중앙값 승률 한국어 (N=10) 3554 2460 1420 약 48% 10 / 10 영어 (N=11) 2772 1504 852 약 55% 11 / 11 여기서 "48% 절감"을 헤드라인으로 쓰고 싶은 유혹이 있었는데, 쓰지 않았다. 프롬프트별 절감폭이 한국어 7
75%, 영어 3492%로 벌어진다. 밀도 높은 기능 명세는 7%밖에 안 줄어든다. 이미 대부분이 필요한 내용이라 깎을 게 없다. 반대로 장황한 baseline을 만난 프롬프트는 92%가 나온다. 게다가 문서 출력은 꼬리가 두꺼워서 같은 프롬프트를 다시 돌리면 셀 값이 수십 포인트씩 움직이고, 가장 장황한 baseline 몇 개는 600초 안에 끝나지 않아 짝지은 집합에서 빠진다(그만큼 절감은 보수적으로 잡힌 셈이다).
단일 실행에서 살아남는 신호는 퍼센트가 아니라 승률이다. 모든 프롬프트에서 baseline보다 작았다는 사실은 재실행해도 잘 뒤집히지 않는다. 중앙값 48%는 그렇지 않다. 그래서 README에도 두 숫자를 나란히 적고 퍼센트에는 추정이라는 꼬리표를 붙였다.
규칙 본문은 단위 테스트가 안 된다
마지막 문제. 이 규칙은 코드가 아니라 LLM에게 주는 지시문이다. "메타 프롤로그를 제거했는가"를 assert 할 방법이 없다.
그래서 검증 범위를 정직하게 좁혔다. 의미가 아니라 존재만 본다. 언어 × dial 조합마다 규칙 파일에 경계 항목과 탈출구가 살아 있는지 확인한다. 한 파일에서 실수로 빠지면 그 파일의 테스트만 실패하니 누락 지점이 바로 보인다.
// tests/test_doc_boundaries.js
const DOCS_BOUNDARY = {                 // 언어별 마커. 한 언어라도 빠지면 명시적 실패
  en: /Docs \/ prose artifacts/,
  ko: /Docs·prose 산출물/,
  ja: /Docs·prose 生成物/,
  hi: /Docs·prose सामग्री/,
  zh: /Docs·prose 产物/,
};
const DOCS_ESCAPE = /Docs escape/;      // 라벨은 모든 언어에서 영문 그대로

for (const lang of VALID_LANGS) {       // registry.json에서 파생 — 새 언어는 자동 포함
  for (const dial of VALID_DIALS) {
    test(`rule ${lang}/${dial} carries the Docs/prose boundary + escape`, () => {
      const boundary = DOCS_BOUNDARY[lang];
      // 맵에 없는 언어는 undefined 매칭으로 조용히 통과하지 않고 여기서 실패
      assert.ok(boundary, `no DOCS_BOUNDARY entry for '${lang}'`);
      const body = fs.readFileSync(path.join(REPO_ROOT, REGISTRY[lang][dial]), 'utf8');
      assert.match(body, /## Boundaries/);
      assert.match(body, boundary);
      assert.match(body, DOCS_ESCAPE);
    });
  }
}
언어 목록을 배열로 박아두지 않고
registry.json에서 파생시킨 게 여기서 값을 했다. 나중에 힌디어를 추가했을 때 이 테스트는 자동으로 그 언어까지 돌았고 마커가 없다고 즉시 실패했다. 배열이었다면 조용히 지나갔다. ko↔en 사이 의미가 정말 같은지는 여전히 리뷰의 몫이고, 테스트 주석에 그렇게 적어 뒀다.설계 대상은 강도가 아니라 경계였다
압축 규칙을 만들 때 진짜 설계 대상은 강도가 아니라 경계다. 대화·코드·영속 문서는 같은 축의 다른 눈금이 아니라 서로 다른 표면이다. 축을 늘려 해결하려 하면 사용자가 매번 축을 골라야 한다. 그리고 출력 토큰을 세는 벤치마크는 모델이 도구를 쓰는 순간 조용히 거짓말을 한다.
지금 register나 스타일 가이드를 운영한다면, 규칙 문서를 열어 "이 규칙이 적용되지 않는 표면"이 명시돼 있는지부터 확인하라. 없다면 코드·대화·영속 문서 세 줄부터 적어 넣으면 된다.
반응형'AI 엔지니어링' 카테고리의 다른 글
심링크에서 복사로 후퇴한 세 번의 작업기 (0) 2026.09.22 골든셋·headless runner로 LLM 판정 게이트 회귀 테스트 작업기 (0) 2026.09.15 멀티프로젝트 Claude Code 설정 운영기 5편 - 30k 깎을 계획으로 시작해 6.3k에서 멈춘 이유 (0) 2026.09.08 멀티프로젝트 Claude Code 설정 운영기 4편 — 룰은 상시 로드가 아니라 적중할 때 로드한다 (0) 2026.09.01 멀티프로젝트 Claude Code 설정 운영기 3편 - Edit는 줘도 commit은 못 준다 (0) 2026.08.25